엔비디아(NVIDIA)의 AI 가속기 그래픽카드(GPU) 한 장이 수천만 원을 호가하고, 전 세계 빅테크 기업들이 물량을 받기 위해 줄을 서는 기현상이 이어지고 있습니다. 그런데 이 엄청난 AI 연산 시스템의 성능을 좌우하는 열쇠는 GPU 칩 자체뿐만 아니라, 그 옆에 바짝 붙어 있는 작은 메모리 반도체에 있습니다.
바로 HBM(High Bandwidth Memory, 고대역폭 메모리)입니다.
왜 엔비디아는 일반 D램 대신 값비싼 HBM을 필사적으로 탑재하며, 왜 SK하이닉스와 삼성전자가 이 시장에서 ‘대체 불가’라는 평가를 받으며 글로벌 증시의 중심에 서게 되었을까요? 복잡한 기술 용어를 걷어내고 가장 직관적인 비유로 원리를 풀어보겠습니다.
1. 1분 비유로 이해하는 HBM : ‘스포츠카’와 ‘1,024차선 고속도로’
컴퓨터가 작동하는 방식을 요리사에 비유해 보겠습니다.
- GPU (연산 장치): 손이 극도로 빠른 수천 명의 특급 요리사들입니다.
- 메모리(DRAM): 요리사 옆에서 재료를 보관하고 전달하는 보조 주방(도마)입니다.
아무리 요리사(GPU)의 손이 빨라도, 재료를 꺼내주는 통로가 좁아 재료 전달이 늦어지면 요리사는 손을 놓고 멍하니 기다려야 합니다. 이를 컴퓨터 구조에서 ‘메모리 벽(Memory Wall, 병목 현상)’이라고 부릅니다.
기존의 일반 메모리(DDR, GDDR)와 HBM의 차이는 도로망에 비유하면 명쾌합니다.
- 일반 GDDR 메모리: ‘시속 300km로 달리는 슈퍼카가 다니는 32차선 도로’입니다. 차 한 대의 속도(전송 속도)는 매우 빠르지만, 차선(데이터 전송 통로, I/O 버스 폭)이 32개 안팎으로 좁습니다.
- HBM: ‘시속 100km짜리 일반 트럭이 다니는 1,024차선 초대형 고속도로’입니다. 차 한 대의 속도는 아주 빠르지 않아도, 1,024개의 차선에서 수천만 개의 데이터를 한꺼번에 쏟아붓기 때문에 총 데이터 전송량(대역폭, Bandwidth)이 비교가 불가능할 정도로 거대합니다.
챗GPT와 같은 거대언어모델(LLM)은 수백억~수천억 개의 매개변수 데이터를 한순간에 들이붓고 계산해야 합니다. 이때 좁은 도로의 슈퍼카 방식은 한계에 부딪히며, 오직 1,024차선 이상의 압도적인 대역폭을 가진 HBM만이 GPU의 연산 속도를 온전히 받쳐줄 수 있습니다.
2. HBM의 구조: 단층 주택을 헐고 아파트를 짓다 (TSV 기술)
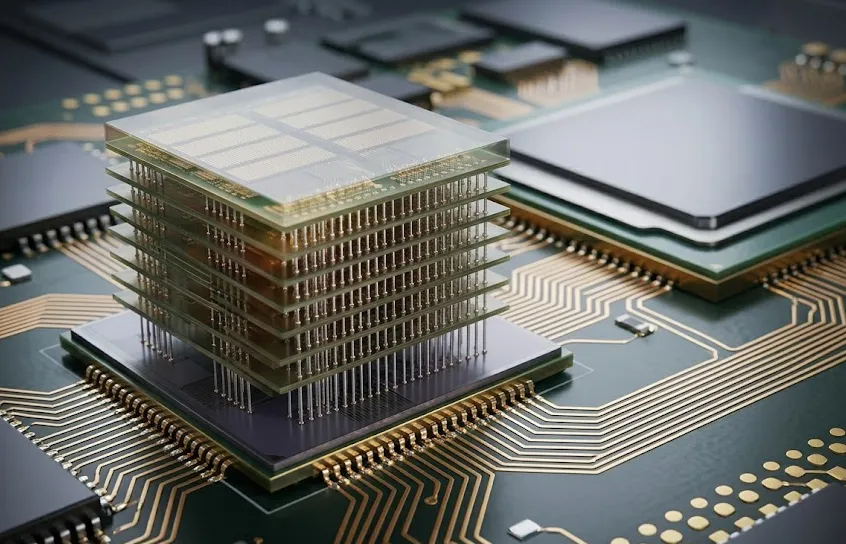
그렇다면 HBM은 어떻게 손톱만 한 공간 안에 1,024개나 되는 엄청난 통로를 만들어 냈을까요? 해답은 ‘수직 적층’에 있습니다.
과거의 D램은 기판 위에 단층 주택처럼 평면으로 넓게 펼쳐져 있었습니다. 하지만 메인보드 위에서 칩 사이의 거리가 멀어질수록 신호가 오가는 데 시간이 걸리고 전력 소모와 열이 심해졌습니다.
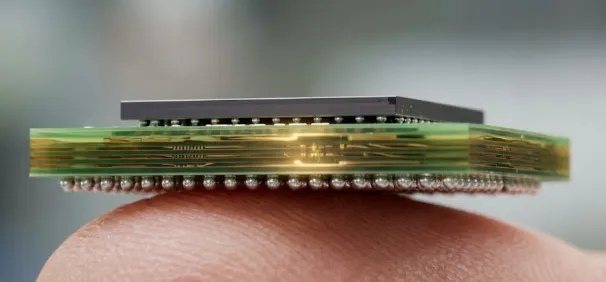
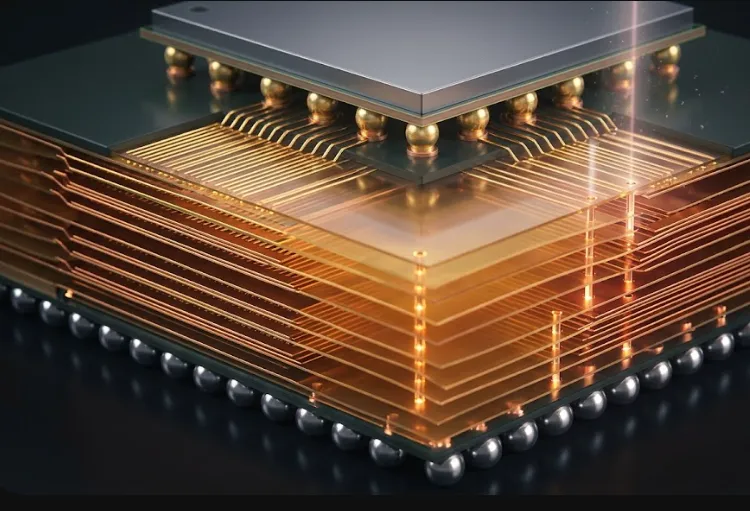
HBM은 이 단층 주택들을 위로 겹겹이 쌓아 올려 8층, 12층, 16층짜리 초고층 아파트를 만들었습니다. 그리고 각 층을 연결하기 위해 D램 칩에 머리카락 굵기의 수십 분의 일에 불과한 미세한 구멍 수천 개를 수직으로 뚫었습니다. 이것을 TSV(Through Silicon Via, 실리콘 관통 전극) 기술이라고 부릅니다.
층과 층 사이를 엘리베이터(TSV)로 직통 연결하니, 데이터가 이동하는 거리가 마이크로미터 단위로 짧아져 지연 시간은 사라지고 전송 속도는 폭발적으로 증가했습니다.
3. 왜 삼성전자와 SK하이닉스만 만들 수 있을까? (진입장벽의 실체)
HBM은 단순한 메모리 반도체가 아니라, 메모리 설계 기술과 최첨단 패키징(조립) 기술이 극단으로 결합된 복합 예술품에 가깝습니다. 전 세계에서 한국의 양대 반도체 기업이 시장 점유율 90% 이상을 틀어쥐고 대체 불가로 군림하는 데는 3가지 높은 장벽이 있습니다.
① 극악의 수율과 미세 정렬 난이도
HBM은 D램 8장~12장을 얇게 갈아내어(Thinned Wafer) 수직으로 쌓습니다. 웨이퍼 두께가 종이 한 장보다 얇아져 쉽게 바스러지고 휘어집니다. 수만 개의 미세 구멍(TSV)을 오차 1마이크로미터(㎛) 이내로 완벽히 정렬해 위아래를 붙여야 하는데, 12장의 칩 중 단 하나의 칩이나 접합점 하나에만 불량이 나도 완성된 HBM 전체를 통째로 폐기해야 합니다. 이 막대한 손실을 감당하며 70~80% 이상의 상업적 양산 수율을 뽑아낼 수 있는 양산 노하우는 수년간 축적된 한국 기업들만의 영역입니다.
② 패키징 접합 및 방열 기술의 독점력
초고속으로 데이터를 주고받는 칩들이 밀집되면 엄청난 열이 발생합니다. 이 열을 어떻게 식히고 칩 사이의 틈을 메우느냐가 HBM 경쟁력의 핵심입니다.
- SK하이닉스의 MR-MUF 기술: 칩을 쌓은 뒤 액체 형태의 보호재(EMC)를 한 번에 주입해 굳히는 방식으로 방열 성능과 공정 속도를 극대화했습니다.
- 삼성전자의 TC-NCF 기술: 칩 사이에 얇은 절연 필름을 끼워 넣고 열과 압력으로 눌러 붙여 구조적 강도와 휨 방지를 유지하는 기술입니다. 이처럼 각 사가 수년간 다져온 독자적인 패키징 레시피와 특수 소재 밸류체인은 후발 주자가 단기간에 흉내 낼 수 없습니다.
③ 엔비디아-TSMC-메모리로 이어지는 ‘폐쇄형 삼각동맹’
HBM은 단독으로 쓰이지 않고, 파운드리 1위 TSMC의 인터포저 기판(CoWoS) 위에서 엔비디아의 GPU 바로 옆에 나란히 안착해야 완성됩니다. GPU 설계사(엔비디아)와 파운드리(TSMC), 그리고 메모리 제조사가 설계 초기 단계부터 긴밀하게 호흡을 맞춰 신뢰성 검증(퀄 테스트)을 통과해야 납품이 가능합니다. 이 견고한 생태계 신뢰 장벽 때문에 중국의 CXMT나 다른 후발 기업들이 시장에 진입하기가 극히 어렵습니다.
4. 투자 시장이 HBM에 열광하는 구조적 이유
기존 메모리 반도체 산업은 경기에 따라 가격이 폭등과 폭락을 반복하는 전형적인 ‘시클리컬(경기순환형) 상품’이었습니다. 공급 과잉이 오면 가격이 반토막 나고 적자를 보던 산업이었습니다.
하지만 HBM은 메모리의 패러다임을 바꿨습니다.
- 수주형 맞춤 반도체로의 전환: 고객사(엔비디아, 빅테크)가 1년 전부터 물량을 계약하고 생산에 들어가는 ‘선주문 제작 방식’입니다. 재고가 쌓여 헐값에 파는 위험이 현저히 낮습니다.
- 압도적인 판가와 마진: HBM의 가격은 일반 범용 D램 대비 수배 이상 비쌉니다. 면적당 마진율이 월등히 높아 전체 실적의 질적 성장을 견인합니다.
- 선단 공정 웨이퍼 흡수 효과: HBM 한 개를 만들려면 일반 D램보다 2~3배 많은 웨이퍼 면적이 소모됩니다. HBM 생산이 늘어날수록 일반 D램 생산 여력이 줄어들어, 결과적으로 레거시 D램 시장의 공급 부족을 유발해 범용 메모리 가격까지 함께 끌어올리는 선순환을 만들어냅니다.
5. 결론 및 밸류체인 체크포인트
HBM은 단순한 부품의 업그레이드가 아니라, 칩의 연산 한계를 돌파하기 위한 반도체 패키징 혁명의 상징입니다.
투자자 관점에서는 HBM3E를 거쳐 차세대 규격인 HBM4(베이스 다이에 파운드리 공정 도입 및 2,048비트 대역폭 확장)로 넘어가는 과정에서, 한국의 제조사들이 기술 주도권을 지속하는지, 그리고 고단 적층용 TSV 장비(TC 본더), 검사 장비, 방열 특수 소재 기업들이 글로벌 공급망 내에서 어떤 역할을 확대해 나가는지 주목할 필요가 있습니다.
본 콘텐츠는 개인적인 학습과 이를 바탕으로 한 정보 공유 목적의 자료이며, 금융투자상품에 대한 매매 권유나 전문적인 투자 자문이 아닙니다. 공개된 데이터와 기술 자료를 기반으로 신뢰성을 기하여 작성하였으나 내용의 완전성이나 최신성을 보장하지 않으며, 모든 투자의 최종 판단과 결과에 따른 책임은 투자자 본인에게 있습니다.